
こんにちは、みゃおゆぅです!
漫画作りを進めていくと言いながら、すっかりPixAIにハマってしまっているみゃおですw
いや、長い目で見ればこれもタイパ創作には必要なことだと信じています!
と言いますのも、今回のテーマであるPixAIのLoRAという機能、これを使いこなせればオリジナル作品のタイパ創作も可能ではないかと考えているからです。
この機能を簡単に説明しますと、複数の画像を参考とし、ポイントとなる内容(キャラ、ポーズ、作風等)を指定して学習させることで生成精度を高める機能、らしいです。
と言っても、マニュアルを読んでもよくわからないので、実際に試してみました。
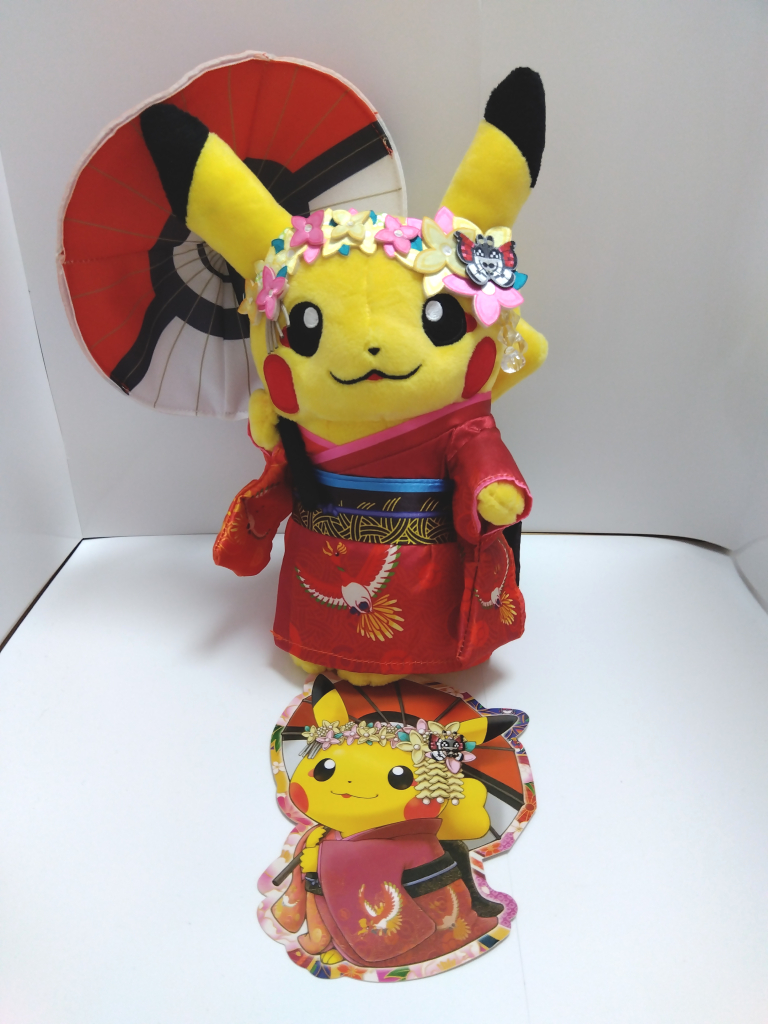
今回、舞妓さんのピカチュウを生成したいと思います! この衣装は公式のぬいぐるみでもある由緒正しき内容なので、(公式に見つかっても)問題ないと信じてます!
まず、普通にプロンプトで生成を試してみましょう。
とりあえず、こんな感じのプロンプトで。(全部手打ちだと面倒なので、じぇみぃに投げてからプロンプトを調整しました)
character: pikachu, female pikachu with heart-shaped tail, wearing red traditional Japanese outfit with obi, adorned with star-shaped hair accessories and purple ribbons with green leaves, pink heart-patterned background filled with sparkling glitter effects, soft shading style, close-up composition(キャラクター:ピカチュウ(ハート型の尻尾を持つメス)、赤い和装(帯付き)を着用、星形の髪飾りと緑の葉をあしらった紫のリボンを身につけている、キラキラと輝くエフェクトが散りばめられたピンクのハート柄の背景、柔らかな陰影のスタイル、アップの構図)
さて、どんな出来になるでしょうか?
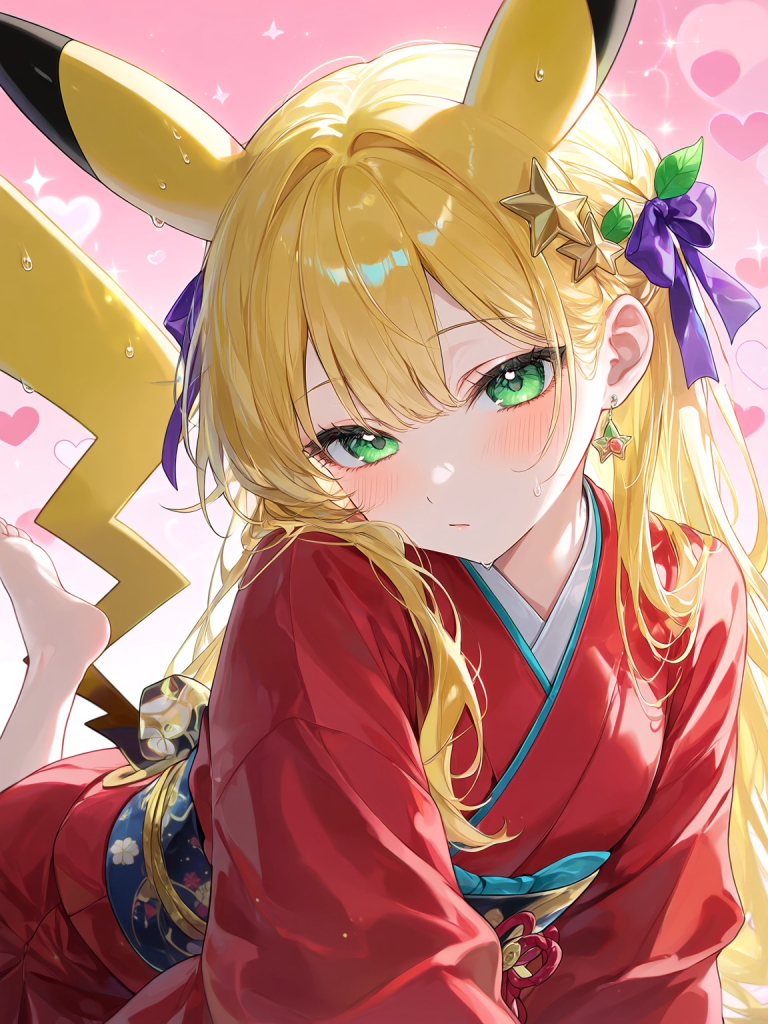
いや、誰だよwww
えーと、調べてみたのですが、基本的にPixAIは女性キャラクターを得意とした生成AIなので、ちびキャラや動物キャラ、男性をプロンプトのみで再現するのは苦手とのことで、擬人化されたキャラクターが生成されやすい傾向にあるということです。
ではどうすれば良いのか?
そこで使うのがLoRAになります!
前の投稿ではPixAI Editを使用すれば参考画像を元にして画像を再生成することができると説明したのですが、LoRAは上限100枚まで画像を参考として学習させられるので、再現性の精度が非常に高くなるとのことです!
ではさっそくLoRA学習をさせようと思いましたが、元にする画像はどうするん?、という話ですよね。他の方々が作製した画像をあされば楽なのですが、それは気が引けるので自分が描いてた画像を20枚くらいかき集めてとりあえず学習させてみました。学習が完了するまで30分~1時間くらいでしたでしょうか。
では、改めて生成してみましょうか。(実際のプロンプトは長いんで、省略してます)
1 female pikachu, bright yellow fur, long ears with black tips, circular red cheeks, half-open eyes with long lashes, and highlights, smile, sexually inviting expression, tail with lightning bolt shape and heart-shape, patterned vermilion furisode kimono, elegant traditional Japanese patterns, ornate violet obi, crown of pink flowers and a blue butterfly hair ornament, dancing, holding folding fans in both hands, dynamic, feminine and elegant pose, seductiveness (メスのピカチュウ。鮮やかな黄色の毛並み、黒い先端を持つ長い耳、丸い赤い頬、長いまつ毛とハイライトが入った半開きの目、微笑み、誘惑的な表情。稲妻とハートの形を組み合わせた尻尾。朱色地に模様が入った振袖(優雅な和柄)、豪華な紫色の帯。ピンクの花の冠と青い蝶の髪飾りを身につけ、両手に扇子を持って踊っている。躍動感があり、女性らしく優雅なポーズ、そして色香を漂わせている。
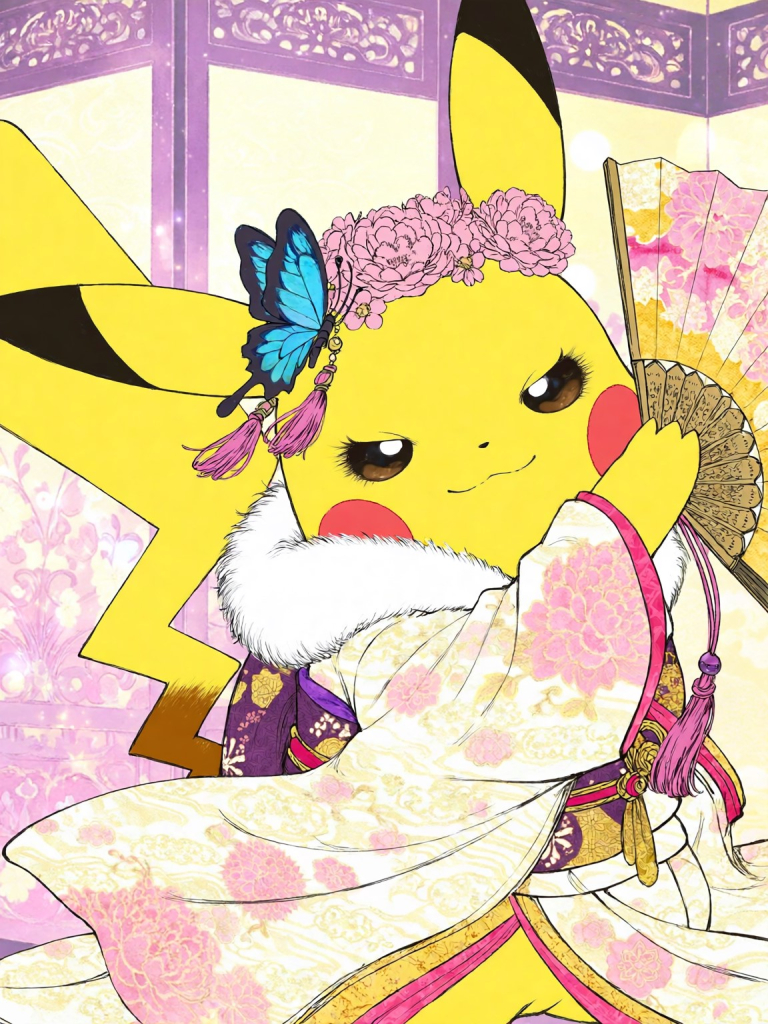
おおっ!! ちゃんと舞妓さんのピカチュウになりました!
女性らしいまつげやポージング、表情などが再現されています、素晴らしい!!
GeminiやChatGPTと同様、参考画像を使用するという点は似ていますが、予め複数の画像を学習させることでより再現度を高くすることができる、それがLoRAということですね!!…多分。
ですが、今回生成した画像、全体的に色が薄くなっています(特に衣装)。
と言いますのも、参考にした画像に手書きの線画も多く使ったことが原因みたいです。色無し画像を並用したことで着色の傾向も薄くするように学習してしまったようです。完成度の高い画像を多く使用する方が精度が高くなるということですね。
で、皆さんお気づきかもしれませんが、ぬいぐるみについていたタグ、
あれを使えばよかったんじゃね
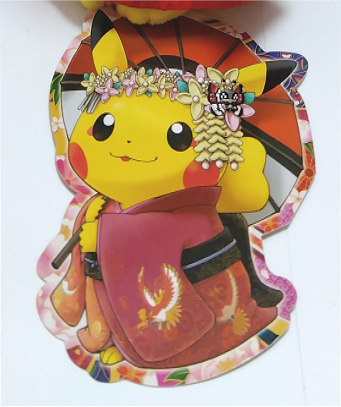
私も、この投稿を編集してる時になって気づきました(泣)
とりあえず、そんな感じでLoRAの使い方がある程度わかりましたので、次はオリジナルキャラクターのLoRA作りを進めようかと思います!
それでは今日はこの辺で失礼いたします。
また次回まで、Life goes on!!
(みゃお>=(yωu^)=
おまけ
LoRAを使用して生成する際に、学習内容として設定するトリガーワードというのがあります。生成時にこのトリガーワードをプロンプトに組み込むことで、LoRAに学習させた内容を出力するらしいです。
今回、メスのピカチュウということで、female PIKACHUをトリガーワードにしたのですが、画像生成時にこのトリガーワードを使用したらこんなことになりました。
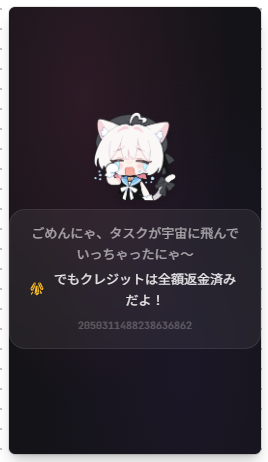
ピカチュウ、宇宙にFly!!
どうやら、著作物が関るワードを直接使用することはできないようで、female PIKAに修正したら生成できるようになりました。皆さまも、2次創作などで著作物を持ち出す場合は注意した方がいいですよ。
コメント